과학, 컴퓨터 비전
ASTRA
- 연구 프로젝트
두 장의 공개 위성 영상을 비교해 건물 변화 후보를 지도로 보여 주는 로컬 연구용 앱입니다.
질문
사전학습된 변화 탐지 모델은 학습에 쓰지 않은 벤치마크에서 얼마나 잘 작동할까요? 짝을 이룬 두 영상이 어긋나거나, 흐려지거나, 순서가 뒤바뀌면 어떻게 될까요?
만든 것
고정된 OpenCV 베이스라인과 사전학습 TinyCD를 비교하는 영상 쌍 워크플로를 만들었습니다. 후보 마스크, 객체 요약, 면적 추정, 벤치마크 진단 결과를 함께 보여 줍니다.
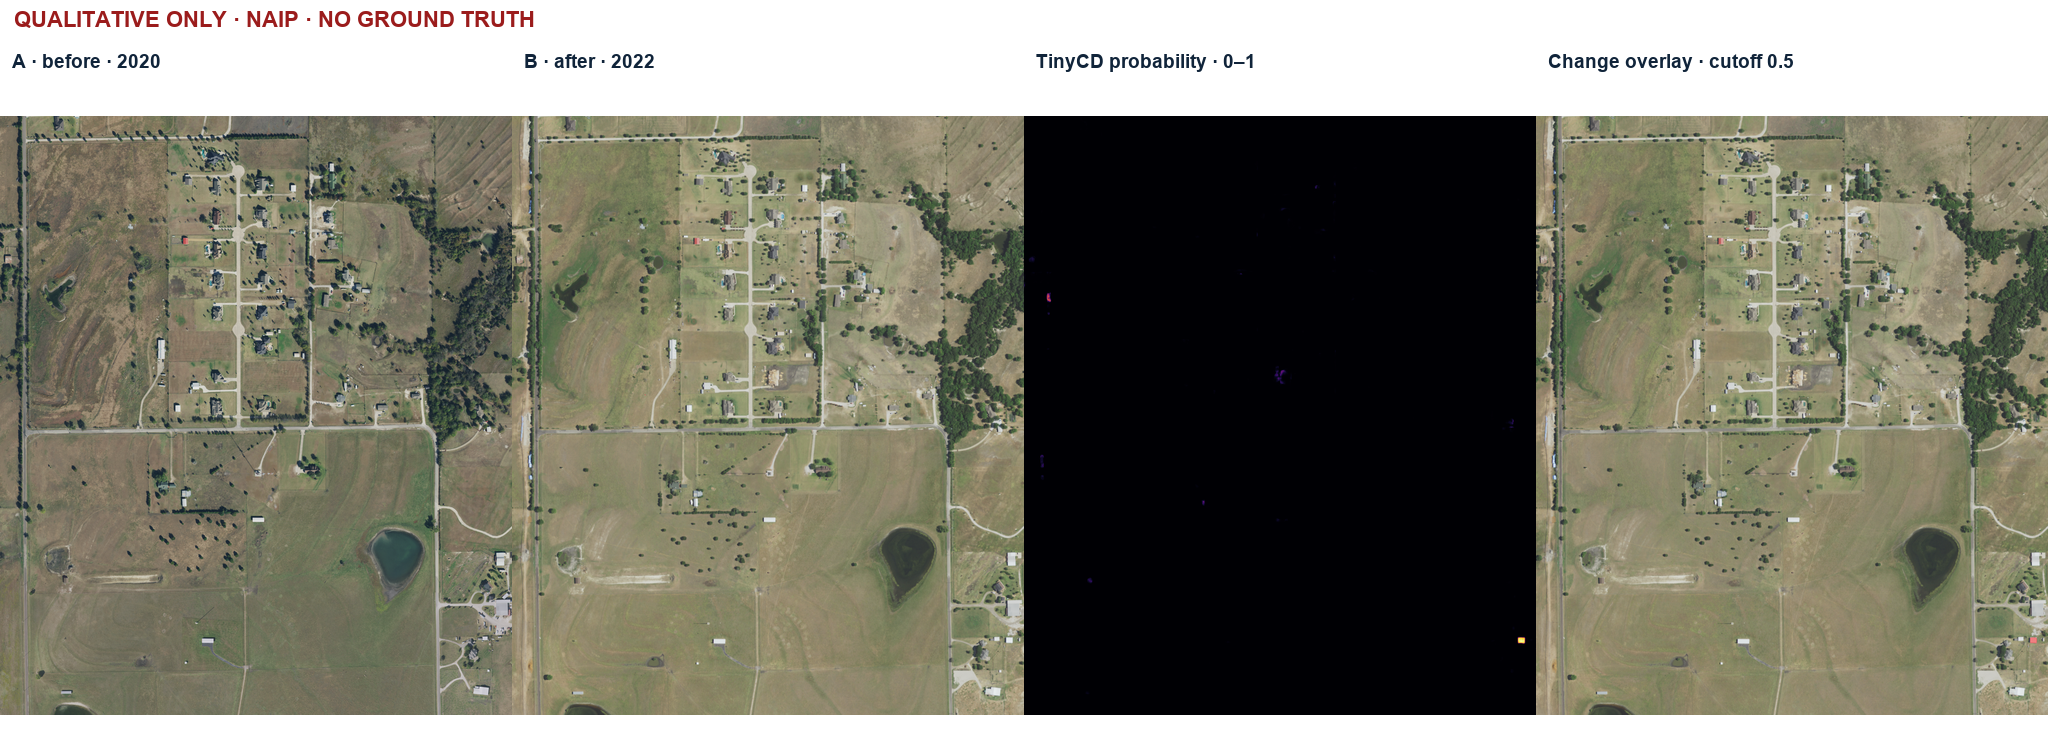
앱은 영상 쌍 입력과 타일 단위 예측을 처리합니다. 로컬 NAIP 예시는 정성적인 보조 시연이며, 벤치마크 채점과는 별개입니다.
평가 방법
핵심 비교에는 학습에 쓰지 않은 LEVIR-CD 시험 세트의 영상 쌍 128개를 썼습니다. Original TinyCD의 결과는 정밀도 0.9266, 재현율 0.8953, F1 0.9107, IoU 0.8360입니다.
강건성 검사는 고정된 32쌍 부분집합으로 했습니다. 5픽셀 어긋남과 흐림 시험의 결과는 그 조건에서만 유효합니다.
주요 결과
학습에 쓰지 않은 시험에서 Original TinyCD는 F1 0.9107, 객체 단위 점수(object skill) 0.953을 기록했습니다. OpenCV 기본 베이스라인과 개선 베이스라인은 F1 0.1306과 0.1003이었습니다.
입력을 5픽셀 어긋나게 하자, 같은 32쌍 강건성 부분집합에서 Original TinyCD의 F1이 대조 조건의 0.9211에서 0.7229로 떨어졌습니다.
사용한 사전학습 TinyCD 모델의 매개변수는 285,128개입니다. 모델 자체의 매개변수 수이며, ASTRA를 위해 학습한 매개변수 수가 아닙니다.
제 역할과 에이전트 활용
평가 질문을 정하고, 비교 대상을 고르고, 앱 워크플로를 통합했으며, 결과를 내놓기 전에 근거를 검토했습니다.
범위가 정해진 조사와 구현 작업에 Claude와 Codex를 씁니다. 에이전트의 결과물을 검토하고, 어떤 주장을 프로젝트에 담을지는 제가 책임집니다.
한계
벤치마크 점수는 명시한 LEVIR-CD 시험에 대한 것이며, 그 밖의 성능을 보장하지 않습니다. 모델은 새로 생긴 건물을 찾는 쪽에 맞춰져 있고, 사라진 건물 탐지는 검증하지 않았습니다.
강건성 결과는 명시한 벤치마크와 고정된 교란 부분집합에 한정됩니다. 다른 센서에서의 성능이나 사라진 건물 탐지를 입증하지 않습니다.
이 페이지의 NAIP 그림은 정답 라벨이 없는 공공 영상으로 만든 정성적 보조 시연입니다. 채점한 평가가 아닙니다.
오경보 7.48개/km²라는 값은 LEVIR에서 Original TinyCD를 5 m² 이상 객체 기준으로 잰 것입니다. NAIP 객체 수와 함께 참고하는 벤치마크 기준값이며, NAIP에서 잰 오경보율이 아닙니다.
근거와 재현성
코드는 공개되어 있습니다. 자동 테스트 12개는 TinyCD를 설치하면 모두 통과하고, 그중 11개는 내려받기 없이도 돌아갑니다. README에 시험 분할, 평가 절차, 베이스라인 결과, 한계를 적었습니다. TinyCD의 코드와 체크포인트는 비상업 연구용이라, 저장소에 넣지 않고 저자에게서 내려받게 했습니다.
공개한 그림은 USDA NAIP 영상으로 만들었습니다. 이 페이지에는 LEVIR 영상이나 LEVIR에서 파생한 시각 자료가 없습니다.