AI, 컴퓨터 비전, 열적외선
Thermal Drone Detection
- 4에포크 전체 실행
- 공개 데이터만 사용
열상(적외선) 영상에서 소형 드론을 찾는 탐지기입니다. 공개 데이터셋만으로 학습하고 평가했습니다. COCO로 사전학습된 Faster R-CNN을 Anti-UAV300으로 미세조정하고, 학습이 필요 없는 열점(hot-spot) 탐지기와 같은 절차로 비교했습니다. 학습과 조정에 한 번도 쓰지 않은 두 번째 공개 데이터셋으로 일반화 성능과, 새·비행기·헬기에 얼마나 자주 반응하는지를 확인했습니다. 라이브 데모는 없습니다.
GitHub 코드: hyh4867/thermal-drone-detection ↗
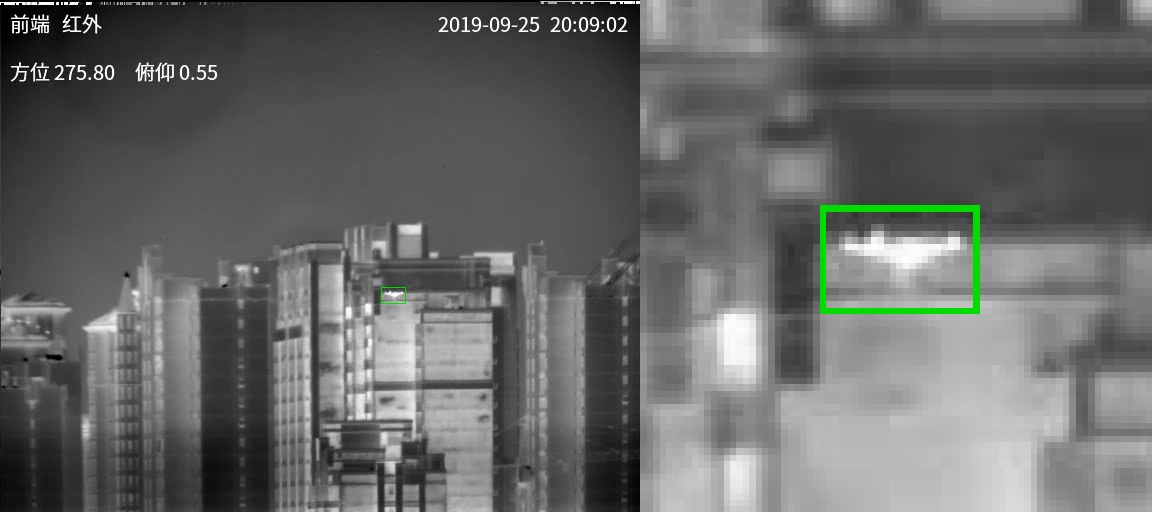
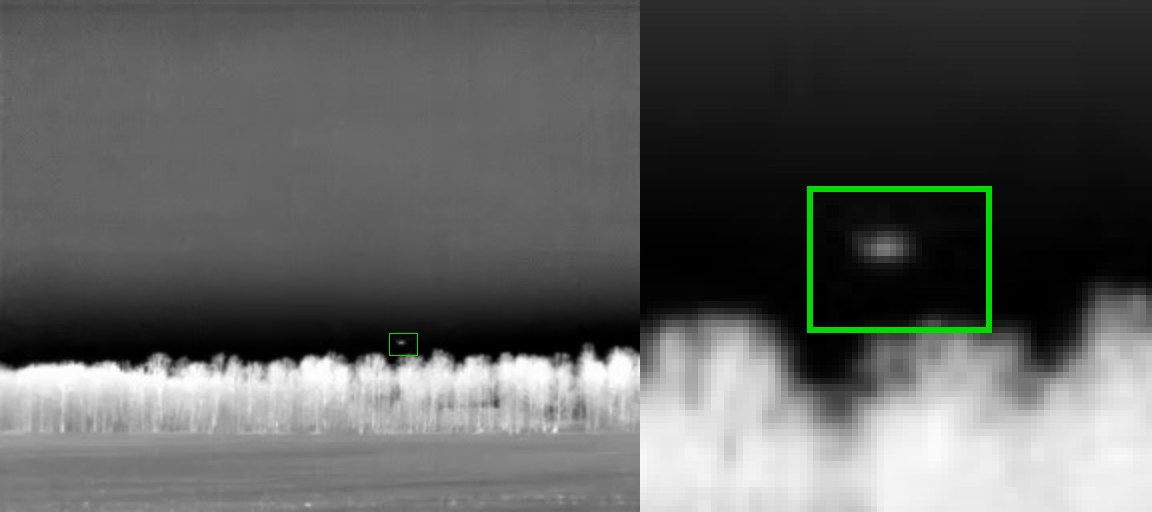
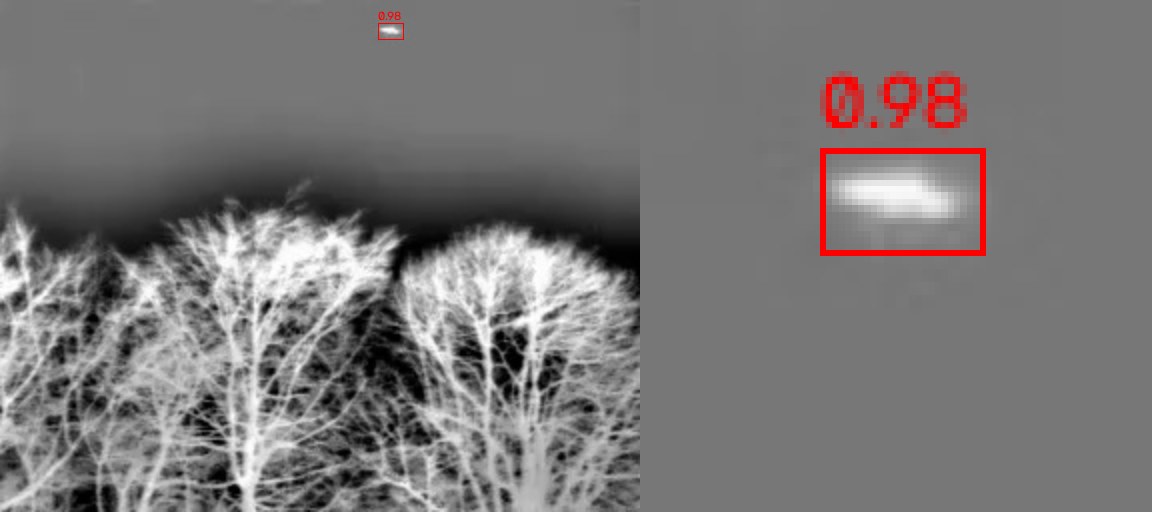
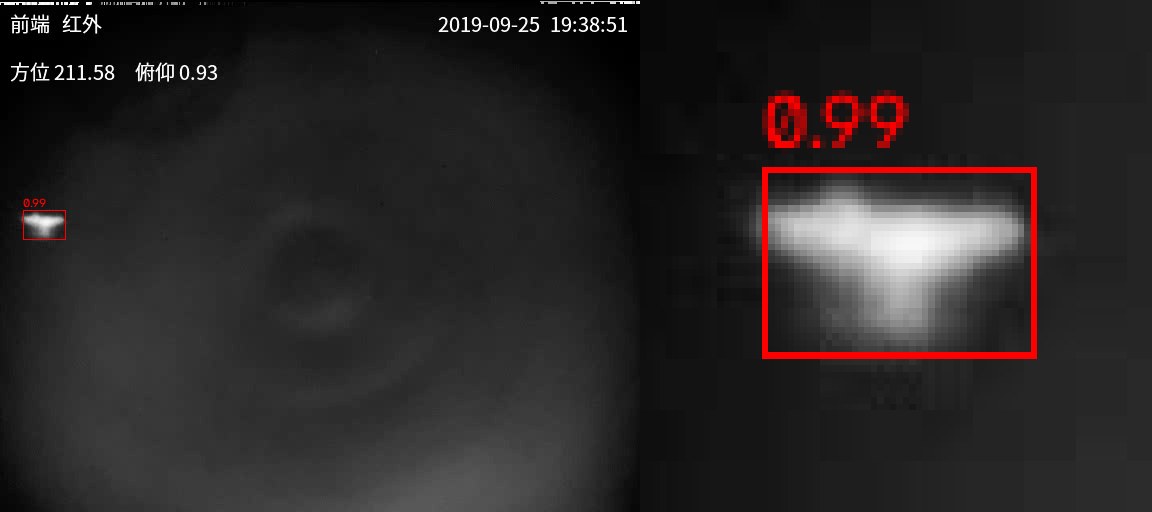
질문
열상 영상 속 드론은 겨우 수십 픽셀 크기인 경우가 많고, 새나 항공기와 비슷해 보이기도 합니다. 사전학습 탐지기를 공개 열상 영상으로 미세조정하면 단순한 열점 탐지기보다 얼마나 나아질까요? 다른 카메라와 장소에서 찍은 영상에서는 어떻게 될까요?
만든 것
Anti-UAV300(적외선 영상만)과 Svanström et al. 2021 다중 센서 드론 데이터셋을 위한 데이터 파이프라인을 만들었습니다. 영상마다 프레임 수와 라벨 수를 대조하고, 프레임을 추출하며, 두 번째 데이터셋은 평가에만 씁니다. 라벨이 프레임과 맞지 않은 영상 다섯 개는 모델을 돌리기 전에 제외했습니다.
데이터를 나누다가 Anti-UAV의 공식 train과 validation이 원본 영상 27개 중 26개를 공유한다는 것을 발견했습니다(시퀀스 이름으로 원본 영상을 알 수 있습니다). 클립 단위로 나누면 거의 같은 장면이 양쪽에 들어가므로, 두 세트를 합쳐 원본 영상 단위로 다시 나눴습니다. 학습에 원본 영상 22개, 검증에 5개입니다. 공식 test 세트(다른 원본 영상 10개에서 나온 시퀀스 91개)는 그대로 두었습니다.
학습이 필요 없는 베이스라인은 형태학적 top-hat 필터로 뜨겁거나 차가운 점을 찾아 박스를 칩니다. 커널 크기, 임계값, 카메라가 프레임에 새기는 글자를 가리는 마스크는 검증 데이터로만 골랐습니다.
모델은 torchvision의 Faster R-CNN(ResNet-50 특징 피라미드, BSD-3-Clause)이며, Apple M2에서 4에포크 동안 미세조정했습니다. 앵커를 작게(8 px부터) 바꾸고, 320픽셀 크롭과 무작위 축소를 썼습니다. Ultralytics YOLO 대신 이 모델을 고른 것은, YOLO의 AGPL-3.0 라이선스가 MIT 라이선스인 이 프로젝트에 카피레프트 의무를 지우기 때문입니다.
Anti-UAV300 시험 세트 결과
| 지표 | Top-hat 베이스라인(학습 없음) | 미세조정한 Faster R-CNN |
|---|---|---|
| AP@0.5 | 0.139 [0.108–0.177] | 0.885 [0.839–0.926] |
| 정밀도 | 14.7% (4,759 / 32,371) [12.7–17.0] | 96.7% (7,154 / 7,401) [95.2–97.8] |
| 재현율 | 56.5% (4,759 / 8,429) [48.7–64.2] | 84.9% (7,154 / 8,429) [80.0–89.6] |
| 드론 없는 프레임의 오경보율 | 99.5% (1,147 / 1,153) [98.2–100.0] | 3.5% (40 / 1,153) [0.8–8.9] |
처음 보는 데이터셋에서
| 지표 | Top-hat 베이스라인(학습 없음) | 미세조정한 Faster R-CNN |
|---|---|---|
| 드론 재현율, 전체 거리(영상 154개) | 9.6% (899 / 9,382) [6.4–12.5] | 48.6% (4,561 / 9,382) [42.1–54.8] |
| 근거리, 20 m 미만(영상 23개) | 25.1% (367 / 1,462) [15.0–35.8] | 66.0% (965 / 1,462) [54.0–77.2] |
| 중거리, 20–60 m(영상 93개) | 9.6% (529 / 5,528) [6.0–13.0] | 57.4% (3,175 / 5,528) [50.1–64.4] |
| 원거리, 60 m 초과(영상 38개) | 0.1% (3 / 2,392) [0.0–0.4] | 17.6% (421 / 2,392) [9.8–26.7] |
| 새 영상 프레임의 드론 경보 | 77.5% (3,777 / 4,872) [69.1–85.0] | 23.0% (1,119 / 4,872) [16.1–30.3] |
| 새를 드론으로 오인 | 0.1% (3 / 4,330) [0.0–0.2] | 3.1% (133 / 4,330) [1.4–5.3] |
| 비행기 영상 프레임의 드론 경보 | 89.1% (4,166 / 4,678) [82.4–94.8] | 45.3% (2,118 / 4,678) [35.6–54.6] |
| 비행기를 드론으로 오인 | 4.7% (218 / 4,678) [1.8–8.4] | 11.8% (552 / 4,678) [7.2–16.6] |
| 헬기 영상 프레임의 드론 경보 | 78.7% (2,689 / 3,415) [68.6–88.0] | 51.7% (1,764 / 3,415) [40.3–63.5] |
| 헬기를 드론으로 오인 | 6.3% (215 / 3,415) [2.3–11.2] | 19.1% (651 / 3,415) [11.3–29.0] |
학습
| 에포크 | 검증 AP@0.5 | 학습 손실 | 소요(분) |
|---|---|---|---|
| 1 | 0.8916 | 0.0405 | 43 |
| 2 | 0.9303 | 0.0406 | 44 |
| 3 | 0.9373 | 0.0414 | 45 |
| 4 | 0.9374 | 0.0415 | 45 |
평가 방법
라벨된 드론과 IoU 0.5 이상 겹치면 찾은 것으로 셉니다. AP@0.5는 정밀도–재현율 곡선 아래 면적입니다. 오경보율은 드론 없는 프레임 중 임계값을 넘는 박스가 하나라도 나온 프레임의 비율입니다.
Anti-UAV 시험: 시험 시퀀스 91개에서 뽑은 9,582프레임, 드론 박스 8,429개, 드론 없는 프레임 1,153장. 크기별 재현율에는 작은 표적이 있는 프레임 340장을 더했습니다. 이 데이터셋에는 작은 표적이 드물기 때문입니다.
Svanström: 5프레임마다 1장, 학습과 조정에 쓰지 않았습니다. 새·비행기·헬기 영상에서는 두 가지를 잽니다. 프레임에서 드론 경보가 하나라도 났는지, 그리고 물체 라벨이 있는 프레임에서 드론 박스가 그 물체 위에 있었는지입니다.
대괄호는 1,000회 재표본한 영상 단위 bootstrap 95% 구간입니다. 재표본 단위는 Anti-UAV가 시험 시퀀스, Svanström이 영상입니다.
주요 결과
Anti-UAV 시험 세트에서 미세조정으로 AP@0.5가 0.139에서 0.885로 올랐고, 드론 없는 프레임의 오경보율은 99.5%에서 3.5%로 줄었습니다. 학습 없는 베이스라인은 드론 없는 프레임 1,153장 중 6장을 빼고 모두 경보를 냈습니다.
표적 크기(√(w·h))별 재현율은 8–16 px 71.8%(262 / 365), 16–32 px 78.2%(1,537 / 1,965), 32–64 px 86.7%(5,440 / 6,272), 64 px 이상 100%(150 / 150)였습니다. 8 px 미만 표적 17개는 하나도 찾지 못했습니다.
처음 보는 데이터셋에서는 드론 재현율이 84.9%에서 48.6%로, 60 m보다 먼 드론에서는 17.6%로 떨어졌습니다. 한 데이터셋 안에서 잰 점수는 다른 카메라와 장소로 그대로 옮겨 가지 않았습니다.
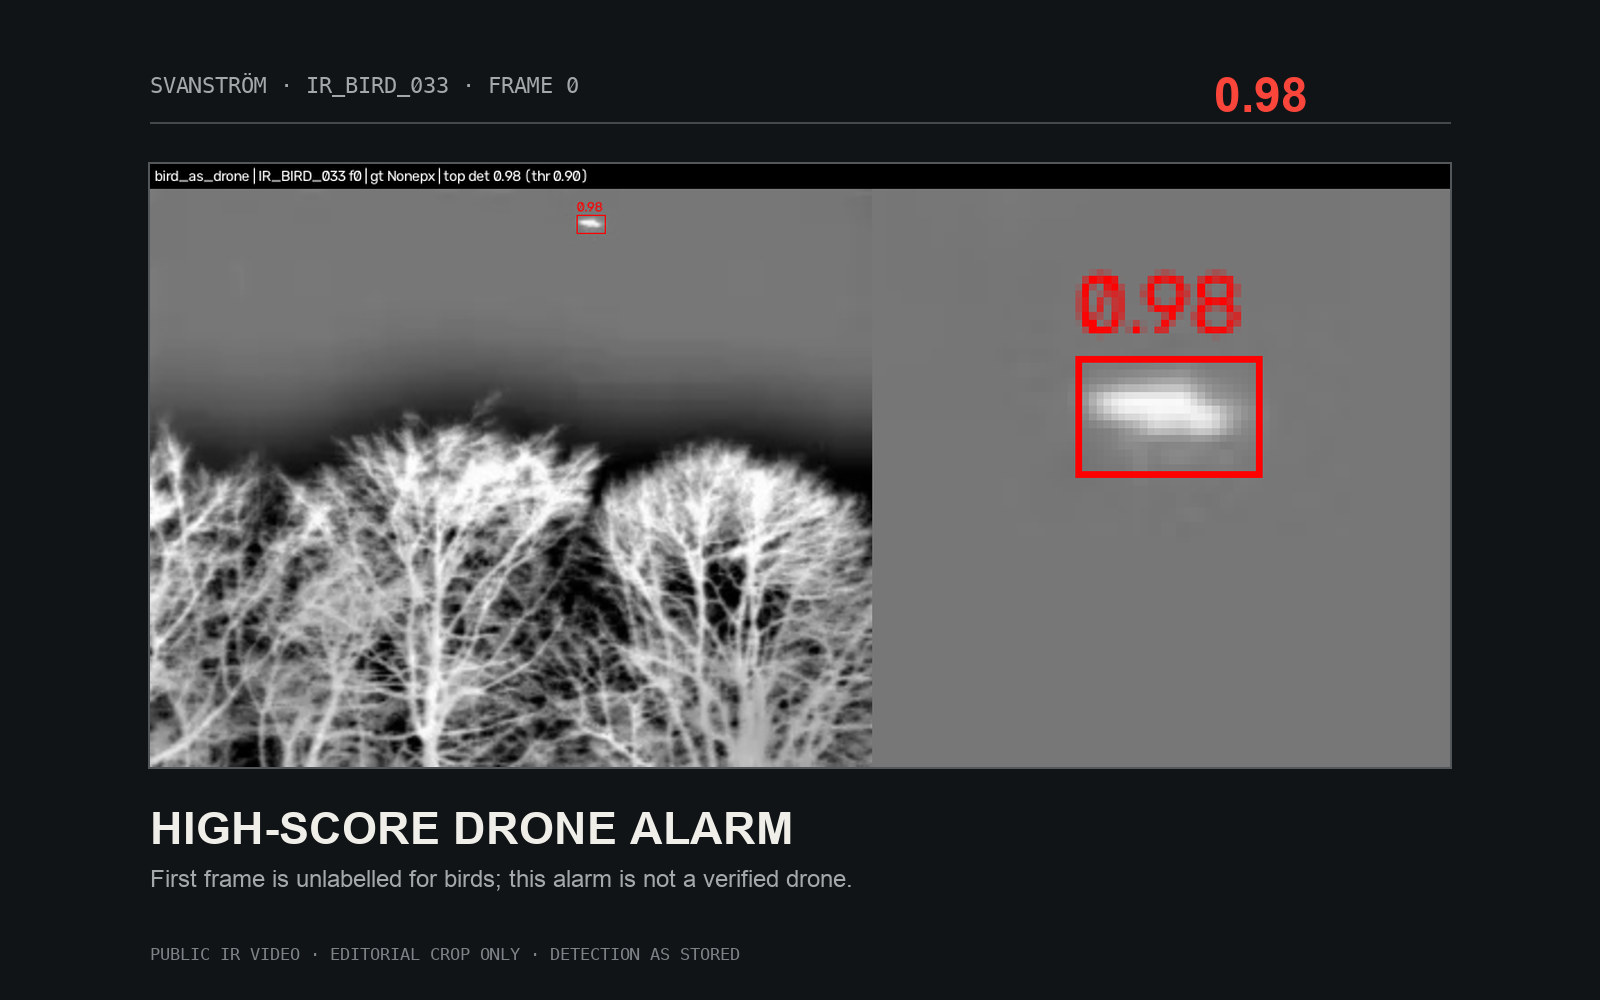
새·비행기·헬기 영상에서 난 경보는 대부분 라벨된 물체 위가 아니었습니다. 이 영상 프레임의 23–52%에서 드론 경보가 났지만, 드론 박스가 새나 항공기 자체에 있었던 경우는 라벨된 프레임의 3–19%뿐이었습니다. 나머지 중 일부는 라벨이 빠진 물체이거나 IoU 0.5에 못 미친 박스일 수 있으며, 하나씩 확인하지는 않았습니다.
제 역할과 에이전트 활용
규칙을 정했습니다. 공개 데이터셋만 쓰고, 영상 단위로 나누고, 임계값은 검증 데이터로만 고르고, 모든 수치는 실제 실행에서 가져옵니다. 첫 글을 낼 때는 1에포크에서 멈추고 축소 표본으로 채점했지만, 이후 4에포크 전체 학습과 전체 평가로 이 페이지의 모든 수치를 바꿨습니다.
Claude가 제 지시에 따라 데이터 파이프라인, 베이스라인, 학습, 평가를 범위가 정해진 단계로 구현했습니다. 결과물을 검토했고 이 페이지의 주장은 제가 책임집니다.
한계
8 px 미만 시험 표적은 17개뿐이고 두 방법 모두 하나도 찾지 못했습니다(0 / 17). 아주 작은 드론에 대해서는 결론을 낼 수 없습니다. 놓친 작은 표적 라벨 중 일부는 프레임 가장자리에 드론 없이 라벨만 있어 라벨 오류일 수 있으나, 하나씩 확인하지는 않았습니다.
베이스라인의 선택값 k = 1.5가 탐색 범위의 하한에 걸렸습니다. 베이스라인 성능이 조금 낮게 잡혔을 수 있습니다.
Anti-UAV 시험 세트는 원본 영상 10개에서 나왔습니다. bootstrap 단위인 시퀀스 91개가 이 10개에서 나왔으므로 구간이 넓고, 같은 원본 영상의 시퀀스끼리 상관이 있어 실제 불확실성은 이보다 더 클 수 있습니다.
학습은 한 번에 끝나지 않았습니다. 1에포크는 원래 설정(데이터 로더 worker 2개, batch 8)으로, 2–4에포크는 1에포크 끝의 체크포인트와 옵티마이저 상태에서 저메모리 설정(worker 없음, 2장 × 4단계 gradient accumulation, 유효 batch 8)으로 이어서 학습했습니다. PyTorch 전역 난수 상태를 복원하지 않았으므로 검출기 내부의 무작위 영역 샘플링은 중단 없는 실행과 다르고, MPS에서 다시 학습하면 소수점 아래 값이 달라질 수 있습니다.
두 데이터셋 모두 특정 카메라와 장소에서 찍었고, 두 번째 데이터셋은 주간 영상뿐입니다. 이 결과는 다른 센서, 날씨, 운용 환경에 대해 아무것도 말해 주지 않습니다.
아래 실패 사례는 첫 실행(1에포크) 모델로 만든 것이며, 전체 실행 모델로 다시 만들지 않았습니다.
근거와 재현성
코드, 설정, 전체 실행 결과(results/full/: 비교표와 두 방법의 지표 파일)를 첫 실행 결과, 실패 사례 모음과 함께 공개 저장소에 올렸습니다. 모든 결과 파일에 설정 해시, 데이터셋 압축 파일마다의 SHA-256, 실행 당시 제 비공개 작업 저장소의 커밋을 기록했습니다. 공개 저장소는 새 기록에서 시작합니다. 시드는 0으로 고정했습니다.
데이터셋: Anti-UAV300(저장소는 MIT License)과 Svanström et al. 다중 센서 드론 데이터셋(데이터는 CC0 1.0, 논문은 CC BY 4.0). 모델 가중치와 원본 영상은 공개하지 않습니다.
Jiang et al., Anti-UAV: A Large Multi-Modal Benchmark for UAV Tracking (arXiv:2101.08466) ↗
Anti-UAV dataset repository (MIT License) ↗
Svanström et al. drone detection dataset, Zenodo (CC0 1.0) ↗